Chất lượng dữ liệu
Trong ngành có một câu cửa miệng, gọn đến mức nghe qua tưởng đùa: rác vào thì rác ra.
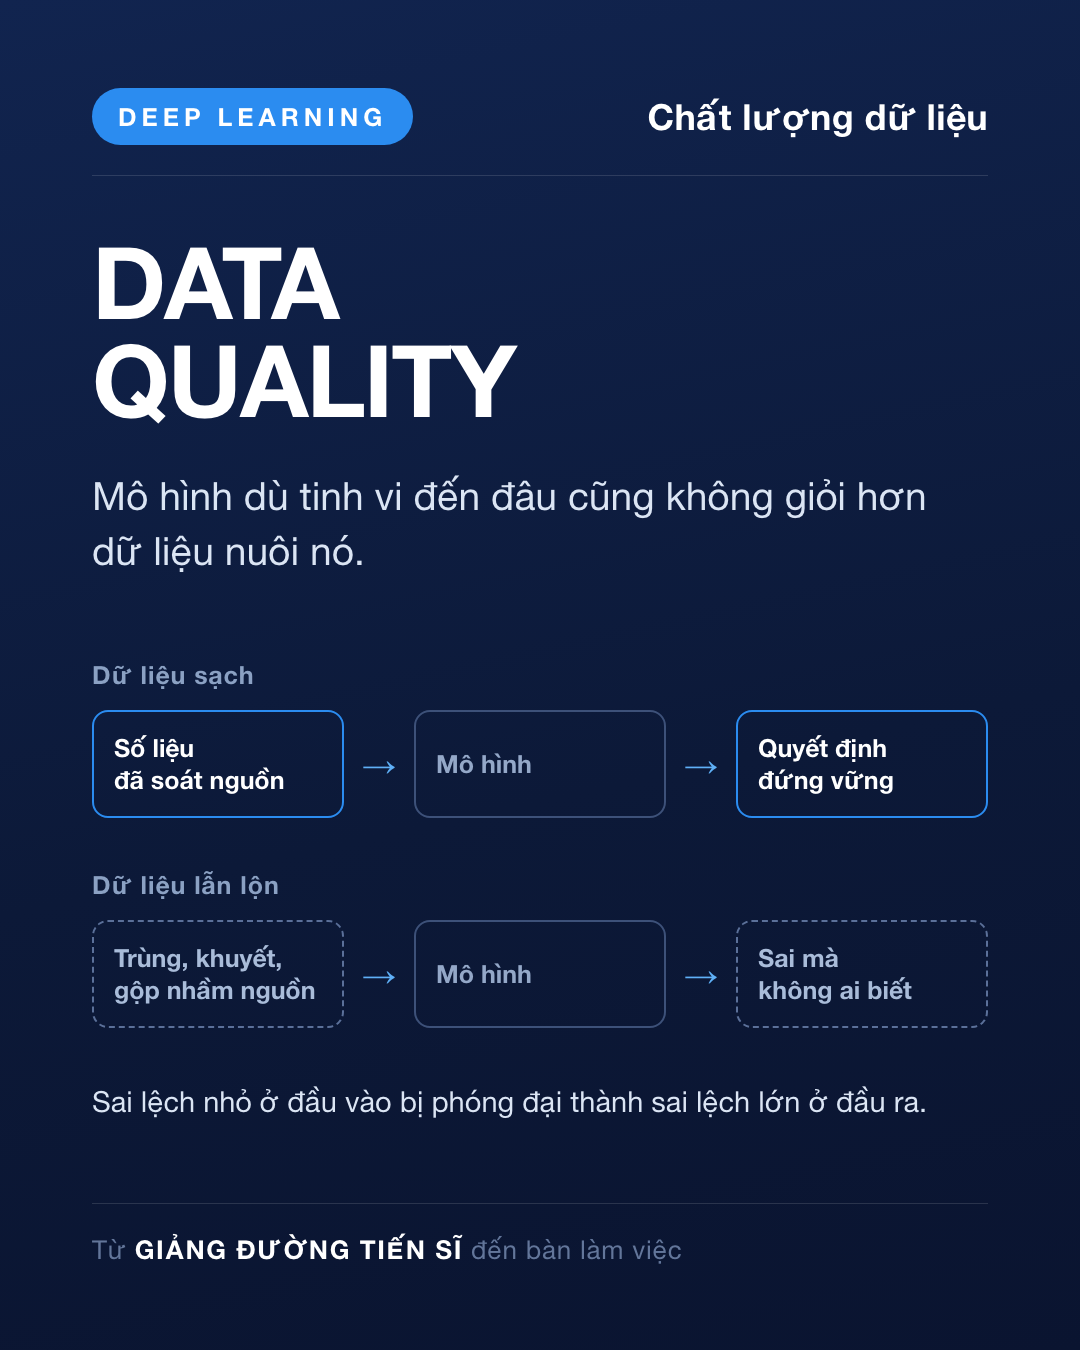
Trong ngành có một câu cửa miệng, gọn đến mức nghe qua tưởng đùa: rác vào thì rác ra (garbage in, garbage out). Ý là một mô hình dù tinh vi đến đâu cũng không thể giỏi hơn dữ liệu mà nó được cho ăn. Giống như đầu bếp có tài mấy, nguyên liệu đã ôi thì món ăn cũng khó ngon.
Càng học, tôi càng nhận ra phần lớn công sức trong ngành không nằm ở khâu thiết kế mô hình cho hào nhoáng, mà ở khâu lặng lẽ hơn nhiều: dọn dữ liệu cho sạch — bỏ bản ghi trùng, vá những chỗ khuyết, thống nhất lại cách gọi tên. Một ước tính hay được nhắc tới cho rằng người làm dữ liệu dành tới khoảng 80% thời gian chỉ để chuẩn bị và làm sạch, trước khi mô hình học được điều gì đáng giá. Lý do rất thực tế: một sai lệch nhỏ ở đầu vào sẽ bị phóng đại thành sai lệch lớn ở đầu ra.
Chuyện này đúng với tổ chức không kém gì với máy. Theo hãng nghiên cứu Gartner, dữ liệu kém chất lượng khiến mỗi doanh nghiệp thiệt hại trung bình khoảng 12,9 triệu đô la mỗi năm — phần lớn không phải vì sự cố ầm ĩ nào, mà vì những quyết định dựa trên số liệu sai mà chẳng ai kịp nhận ra. Một danh sách khách lỗi thời, một báo cáo gộp nhầm nguồn, một chỉ số đo sai cách — mỗi thứ đều âm thầm đẩy người điều hành đi chệch một chút.
Nên trước khi mong AI cho ra câu trả lời tốt hơn, có lẽ câu hỏi cần đặt trước là: dữ liệu chúng ta đang dựa vào để ra quyết định thật sự đáng tin tới đâu?
Đến bàn làm việc
Một mô hình chỉ tốt bằng dữ liệu nó được học. Công việc của chúng ta cũng vậy: quyết định chỉ tốt bằng thông tin mà nó dựa vào.
Tuần này, thử chọn một báo cáo bạn vẫn dùng đều đặn để ra quyết định — doanh số, tồn kho, hay phản hồi khách — rồi truy ngược đúng một con số trong đó: nó lấy từ đâu, cập nhật lần cuối khi nào, có gộp nhầm nguồn nào không.
Thường thì trục trặc không nằm ở chỗ thiếu dữ liệu, mà ở chỗ ta tin vào một con số mà chưa từng kiểm lại xem nó từ đâu ra.