Học từ phản hồi
Đây là lý do vì sao các trợ lý AI ngày nay biết ý hơn hẳn vài năm trước, dù không hẳn vì chúng to hơn.
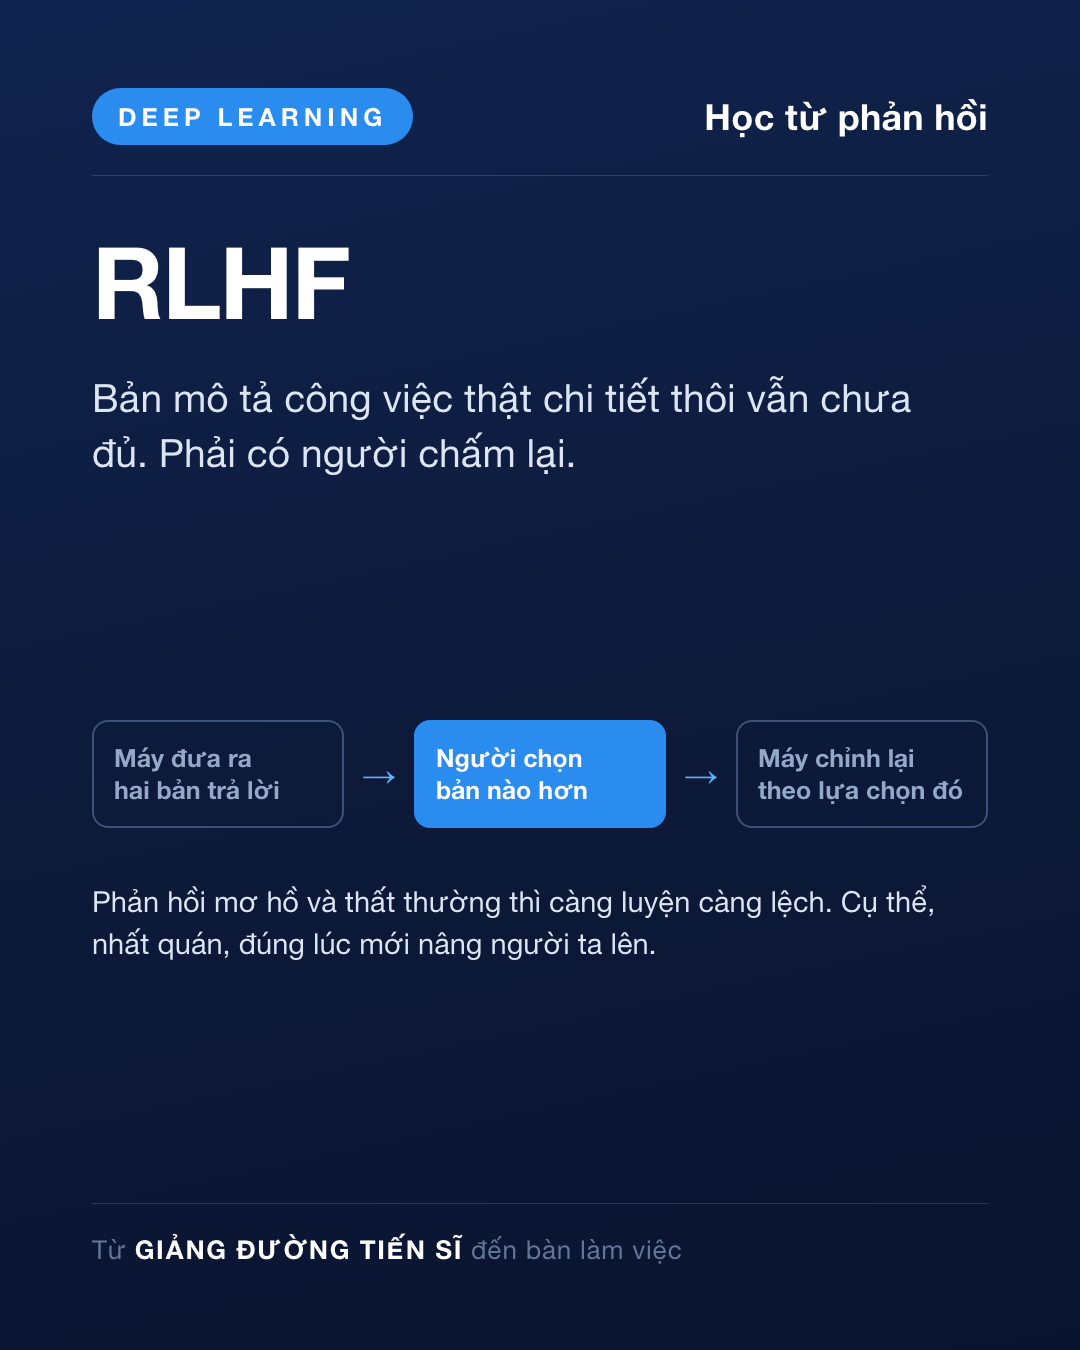
Đây là lý do vì sao các trợ lý AI ngày nay "biết ý" hơn hẳn vài năm trước, dù không hẳn vì chúng to hơn.
Học từ phản hồi con người là gì
Hãy hình dung một nhân viên mới rất thông minh nhưng chưa quen văn hoá công ty. Bạn không viết cho họ một bộ quy tắc khổng lồ. Thay vào đó, mỗi lần họ làm, bạn nói rõ "cách này hợp hơn", "cách kia chưa ổn". Qua nhiều lần phản hồi, họ dần hiểu đâu là một kết quả tốt theo chuẩn của mình.
Học tăng cường từ phản hồi con người (reinforcement learning from human feedback, viết tắt RLHF) làm đúng vậy. Mô hình sinh ra nhiều câu trả lời, con người chấm cái nào tốt hơn, và mô hình được luyện để nghiêng về kiểu câu trả lời được ưa chuộng. Trong nghiên cứu InstructGPT của Ouyang và cộng sự năm 2022, một mô hình chỉ 1,3 tỷ tham số sau khi được huấn luyện bằng phản hồi con người lại được người dùng ưa thích hơn cả GPT-3 gốc 175 tỷ tham số, tức lớn hơn khoảng một trăm lần.
Ứng dụng vào quản trị ra sao
Tôi thấy bài học này rất giống cách một đội ngũ trưởng thành. Năng lực không chỉ đến từ việc tuyển người thật giỏi hay viết thật nhiều quy định, mà đến từ chất lượng và tần suất của phản hồi. Một phản hồi cụ thể, kịp thời, nói rõ tốt chỗ nào và chưa ổn chỗ nào, có sức định hình hành vi mạnh hơn mọi bản quy trình để trong ngăn kéo.
Và cũng như trong huấn luyện mô hình, phản hồi chỉ hữu ích khi tiêu chí thế nào là tốt đủ rõ. Nếu chính người quản lý còn mơ hồ về chuẩn, đội ngũ sẽ học theo một mục tiêu nhoè.
Đội bạn đang nhận được phản hồi cụ thể đến mức nào, và chuẩn một kết quả tốt đã đủ rõ với mọi người chưa?