Đánh giá mô hình
Đây là câu hỏi tôi luôn đặt ra trước khi tin bất kỳ công cụ AI nào: dựa vào đâu mà nói nó tốt?
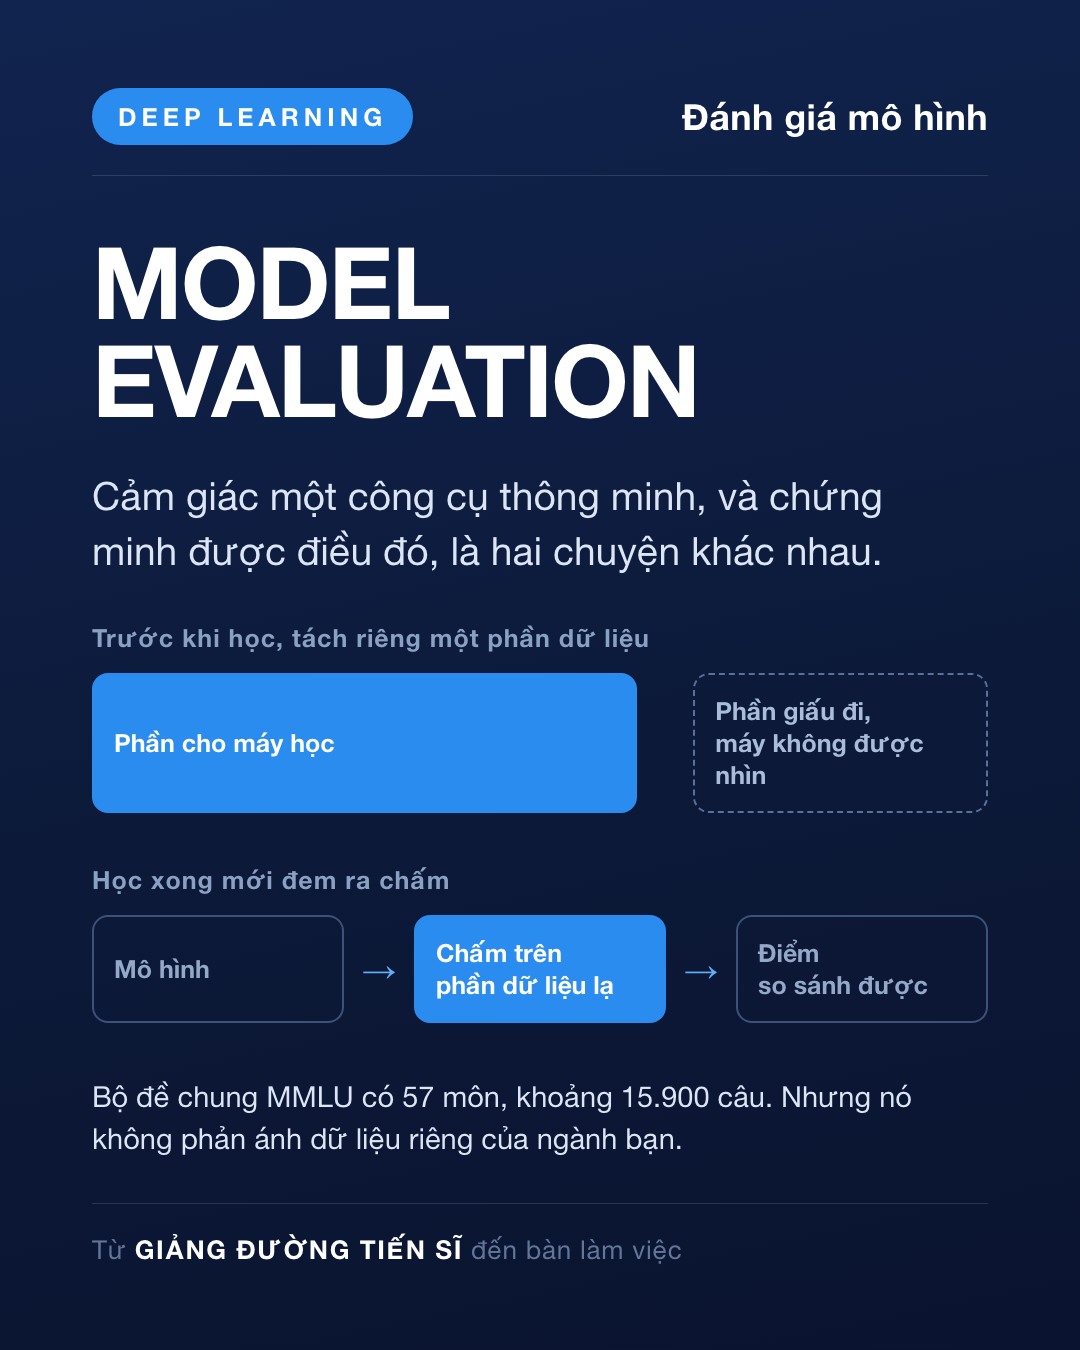
Đây là câu hỏi tôi luôn đặt ra trước khi tin bất kỳ công cụ AI nào: "Dựa vào đâu mà nói nó tốt?"
Đánh giá mô hình là gì
Hãy hình dung việc tuyển một nhân sự. Bạn không chọn chỉ vì họ nói chuyện hay, mà cho họ làm một bài kiểm tra thực tế có đáp án rõ, rồi chấm. Đánh giá mô hình (model evaluation) là đúng việc đó với AI: thay vì tin vào cảm giác nó trả lời nghe xuôi tai, người ta chấm mô hình trên một bộ đề chuẩn đã biết đáp án, rồi đo bằng con số.
Trước khi huấn luyện, người ta tách riêng một phần dữ liệu mà mô hình sẽ không được nhìn thấy trong lúc học, gọi là tập kiểm tra. Học xong, mô hình mới được đem ra chấm trên phần dữ liệu lạ đó. Ngành còn dựng những bộ đề chung để mọi mô hình cùng thi trên một thước đo. Một bộ đề nổi tiếng là MMLU của Hendrycks và cộng sự, giới thiệu năm 2020 và công bố tại hội nghị ICLR 2021, gồm 57 môn từ toán, luật, y tới lịch sử, với khoảng 15.900 câu trắc nghiệm.
Ứng dụng vào quản trị ra sao
Tôi thấy đây là thói quen nhiều doanh nghiệp còn thiếu khi chọn công cụ AI: quyết định dựa trên một buổi trình diễn đẹp thay vì một phép thử trên chính dữ liệu của mình. Một trợ lý AI nghe có vẻ thông minh rất khác với một trợ lý trả lời đúng trên một trăm câu hỏi thật của khách hàng mình.
Cách làm lành mạnh là tự dựng một bộ đề nhỏ của riêng doanh nghiệp: vài chục tình huống thật, có đáp án đúng mà mình mong đợi. Mỗi lần thử một công cụ hay một phiên bản mới, cho nó làm lại bộ đề đó và đếm. Quyết định dựa trên con số luôn vững hơn dựa trên cảm giác.
Nếu phải chấm công cụ AI bạn đang dùng bằng một bộ đề thật của mình, bạn đã có bộ đề đó chưa?